L’edge computing désigne le traitement des données au plus près de leur source, sur des équipements situés en périphérie du réseau plutôt que dans un datacenter centralisé ou un cloud distant. Le concept ne se limite plus à une question de rapidité : depuis l’entrée en vigueur de l’EU Data Act le 12 septembre 2025, le choix de l’emplacement d’un traitement dépend aussi de la portabilité et de la souveraineté des données.
Comprendre l’edge computing aujourd’hui suppose de dépasser la simple définition technique pour intégrer des dimensions réglementaires, architecturales et sécuritaires que le cloud seul ne couvre pas.
A découvrir également : Qu'est-ce que Zero Trust dans CloudFlare ?
Edge computing et réseau 5G : un continuum, pas un serveur isolé
L’image d’un petit serveur installé à côté d’un capteur industriel a longtemps résumé l’edge computing dans l’imaginaire collectif. Cette représentation est devenue trop réductrice.
Les standards 3GPP TS 23.501 et TS 23.558 version 17.4.0 structurent l’edge au sein des réseaux 5G autour de composants dédiés : l’Edge Application Server, qui exécute la logique applicative, et l’Edge Enabler Server, qui orchestre la découverte et l’accès aux services. L’edge forme un continuum entre cloud, réseau et site industriel, avec des couches logicielles normalisées qui permettent de déplacer un traitement d’un nœud à l’autre sans repartir de zéro.
Lire également : Quel est le rôle de Edge ?
Ce modèle explique pourquoi les opérateurs télécoms investissent dans l’edge : ils ne vendent plus seulement de la connectivité, mais du calcul local combiné à des garanties de latence et de localisation des données.
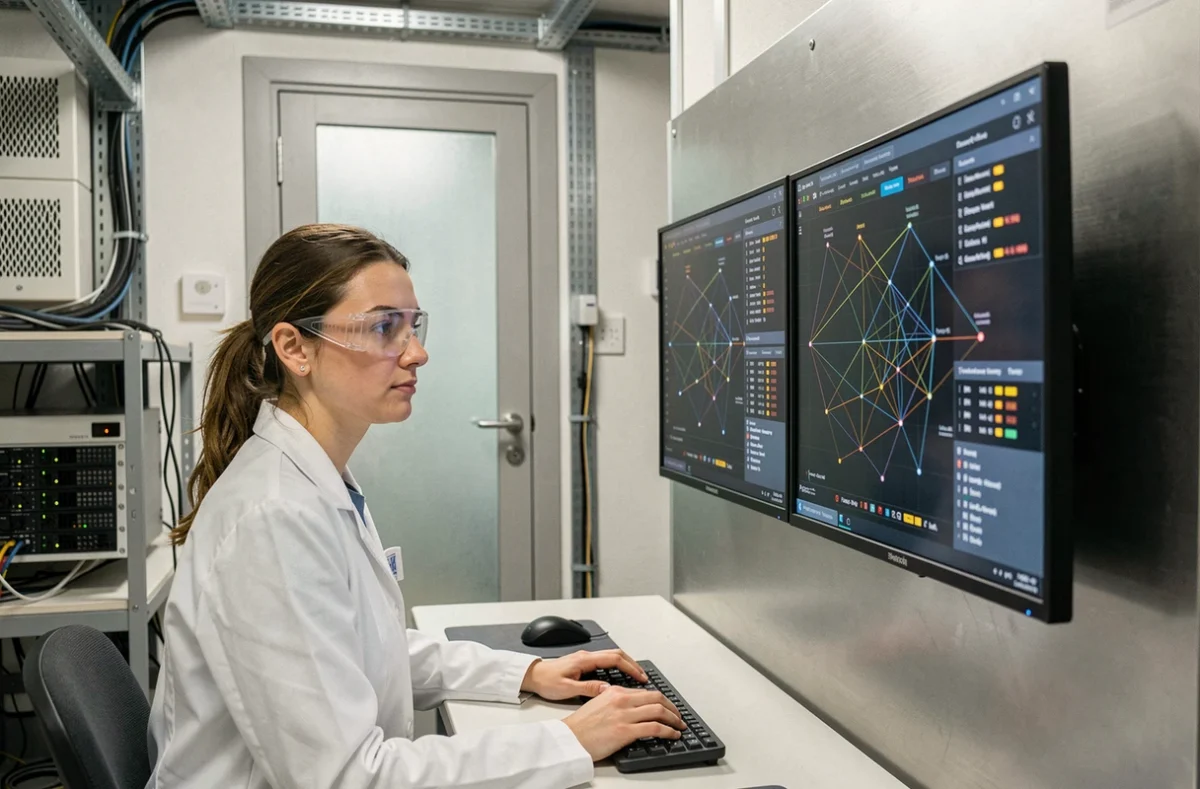
Traitement en périphérie ou cloud centralisé : ce qui change concrètement
Comparer edge computing et cloud computing revient à comparer deux stratégies de placement des ressources de calcul. Le cloud centralise la puissance dans de grands datacenters, parfois situés à des milliers de kilomètres de l’utilisateur final. L’edge rapproche le traitement des appareils qui génèrent les données.
Latence et bande passante
Un véhicule connecté, une chaîne de production robotisée ou un dispositif de vidéosurveillance analytique génèrent des flux massifs en continu. Envoyer l’intégralité de ces données vers un cloud distant crée deux goulets d’étranglement : la latence (le temps d’aller-retour) et la consommation de bande passante. Le traitement local réduit ces deux contraintes simultanément, parce que seules les données utiles, filtrées ou agrégées, remontent vers le cloud.
Souveraineté et conformité réglementaire
L’EU Data Act impose aux fournisseurs de services cloud et edge des obligations d’interopérabilité et de facilitation du changement de prestataire. Pour une entreprise européenne, traiter certaines données sur un nœud edge situé sur son propre site peut simplifier la conformité, puisque les données ne transitent pas par une infrastructure tierce localisée hors juridiction.
La question n’est donc plus uniquement « où traiter pour aller vite », mais « où traiter pour rester conforme ».
Cybersécurité de l’edge : la surface d’attaque qui s’élargit
Distribuer le calcul multiplie les points d’entrée potentiels pour un attaquant. Chaque nœud edge, chaque passerelle, chaque équipement industriel connecté représente une cible supplémentaire par rapport à un datacenter centralisé protégé par des couches de sécurité physiques et logiques concentrées.
Trois textes européens récents encadrent directement cette problématique :
- La directive NIS2 élargit les obligations de cybersécurité à un plus grand nombre de secteurs et impose des exigences de notification d’incidents aux opérateurs d’infrastructures critiques, y compris ceux qui déploient des nœuds edge.
- L’AI Act encadre les systèmes d’intelligence artificielle déployés en Europe, ce qui concerne directement l’inférence locale sur des dispositifs edge lorsqu’elle implique des données personnelles ou des décisions automatisées.
- Le Cyber Resilience Act vise les produits comportant des éléments numériques mis sur le marché européen, incluant les passerelles et équipements edge industriels qui doivent intégrer la sécurité dès la conception.
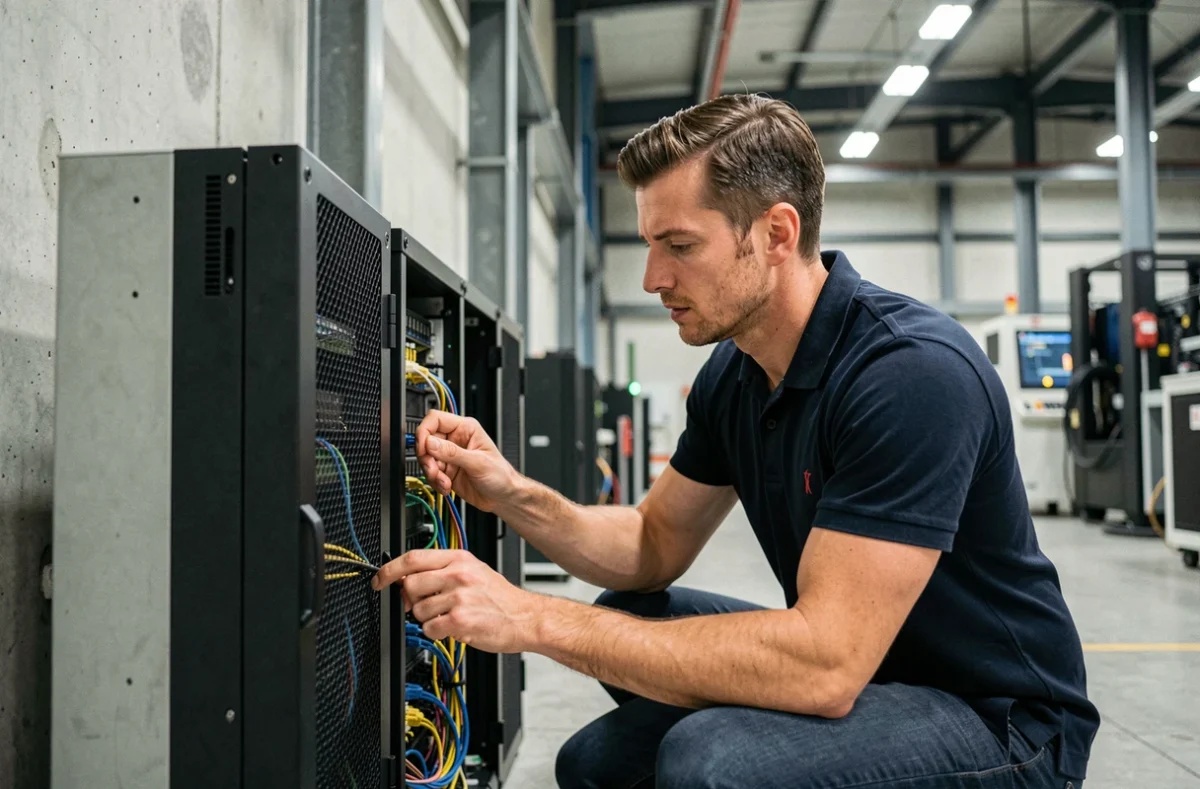
Un déploiement edge ne se résume pas à rapprocher un serveur d’un capteur. Il implique de gérer des mises à jour de sécurité sur des dizaines ou des centaines de sites dispersés, souvent sans personnel informatique sur place.
Inférence IA locale : le nouveau moteur d’adoption de l’edge
L’edge computing a d’abord été adopté pour des applications nécessitant une faible latence : contrôle industriel, jeux vidéo en streaming, réalité augmentée. Le moteur d’adoption a changé.
L’inférence de modèles d’intelligence artificielle directement sur des appareils ou des serveurs edge répond à trois besoins qui dépassent la seule vitesse :
- Le traitement de données sensibles sans les envoyer vers un cloud tiers, ce qui réduit le risque de fuite et simplifie la conformité.
- La capacité à fonctionner dans des environnements déconnectés ou à connectivité intermittente (sites miniers, navires, zones rurales).
- La gestion de pics de charge localisés, où mobiliser un datacenter distant serait trop lent ou trop coûteux en bande passante.
L’IA générative et l’inférence locale accélèrent l’adoption de l’edge bien au-delà des cas d’usage historiques. Les opérateurs télécoms cherchent à combiner connectivité, calcul local et garanties de souveraineté pour proposer des offres intégrées à leurs clients entreprises.
Les limites connues du modèle edge
La gestion opérationnelle reste le frein principal. Administrer une flotte de nœuds edge dispersés géographiquement coûte plus cher, en temps et en compétences, qu’un cloud centralisé où le fournisseur prend en charge l’infrastructure.
L’interopérabilité entre fournisseurs progresse sous la pression réglementaire de l’EU Data Act, mais les standards restent jeunes. Migrer une application d’un environnement edge à un autre n’est pas encore aussi fluide que de changer de région cloud chez un même fournisseur. Les normes 3GPP couvrent l’architecture réseau, pas l’ensemble de la pile applicative.
La sécurité distribuée manque encore de retours d’expérience à grande échelle. Les textes comme NIS2 ou le Cyber Resilience Act posent des exigences, mais les pratiques de sécurité edge restent en cours de maturation dans de nombreux secteurs industriels.
L’edge computing n’est pas un remplacement du cloud. C’est une couche complémentaire qui rapproche le calcul des données quand la latence, la conformité ou la souveraineté l’exigent. La vraie difficulté pour les entreprises n’est pas de comprendre le concept, mais de déterminer quelles charges de travail justifient un traitement local plutôt qu’un envoi vers le cloud, et d’assumer le coût opérationnel qui va avec.